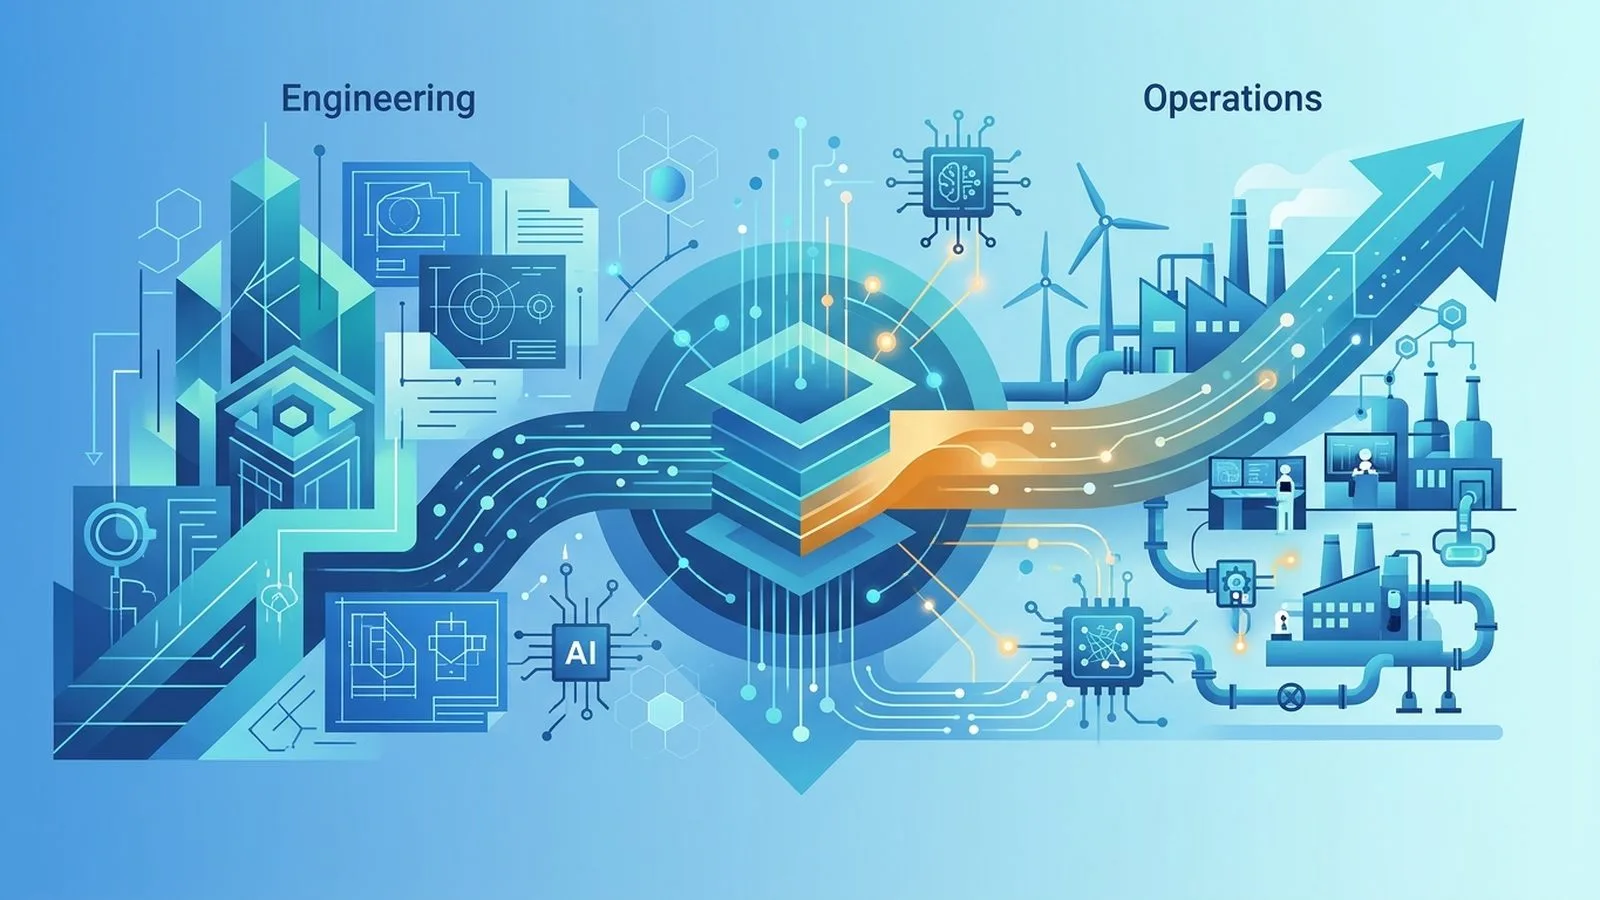
人工智慧(AI)正加速滲透至製造與工程現場,逐步從單點效益測試邁向整體營運導向。工業軟體大廠 AVEVA 在台北技術峰會中展現了跨領域資料整合架構,說明如何透過連結營運與工程端數據,協助產業克服落地障礙。
台灣製造業轉型瓶頸:縮短技術驗證與規模應用的落差
根據人工智慧科技基金會發布的產業調查,傳統製造業已有約 38.5% 的業者進入概念驗證(PoC)或規模應用階段,然而實際達成大規模導入的比例僅占 15.4%。中華經濟研究院的調查則指出,約 69.0% 的製造業者正評估或已導入 AI 方案,其中的 AI 應用主要集中於流程自動化(58.6%)、物聯網與感測設備(27.8%)以及智慧生產(18.3%)。
這些數據共同指出一個現象:企業固然展現了高昂的轉型意願,卻在跨越試驗階段時遇到關卡。現場並不缺乏運轉數據與歷史紀錄,但資訊往往被各自隔離在人機介面(HMI)、監視控制與資料收集(SCADA)、製造執行系統(MES)及歷史資料庫中。若資料缺乏統一的情境脈絡,模型便無法進行準確判讀。
保留工業情境:結合 CONNECT 平台與邊緣運算演算法
為了解決資料碎片化的難題,AVEVA 透過 CONNECT 工業智慧平台與 PI Data Infrastructure 提供貫穿廠區到企業端的架構。其中的 Flows 功能內建超過 800 種協定連接器,可在邊緣端、地端或雲端即時處理資料清理與轉換。此外,針對先進分析需求,系統預計於 2027 年第一季導入結合代理式 AI(Agentic AI)的工業知識圖譜(Knowledge Graph)與數位孿生建構模組,大幅簡化資料結構與情境對應流程。
在場域運行層面,AVEVA Operations Control 支援在邊緣裝置直接部署 C# 或 Python 開發的 AI 演算法,企業可彈性調配雲端與邊緣端負載,落實資料主權與資安合規。而與 IMD 商學院合作的報告亦透露,雖然 74% 主管認同數位生態系的重要性,卻僅有 27% 進行實質資料共享,顯見建立健全資料治理體系的重要性。
數位孿生技術:從單點監控演進為動態最佳化
當即時營運資料結合工程資產資訊,數位孿生(Digital Twin)便能從靜態圖資轉化為具備即時回應能力的模擬環境。透過語意連結與知識圖譜,企業可掌握資產全生命週期的演變,將預測分析反饋至每日工作流程。
在技術峰會現場,台化與李長榮等在地業者亦分享實務經驗,展現跨系統協作如何落實於製造、能源與化工等領域,建立起「資料—模型—行動」的閉環改善機制。
這代表什麼
這項發展說明了「資料品質與情境脈絡」才是工業 AI 能否大規模落地並產生實質回報的決定性關鍵。對許多台灣中大型製造業與中小企業而言,盲目追求昂貴的大型語言模型(LLM)或前端演算法,若無健全的基礎架構支援,最終往往流於孤立的分析儀表板。
唯有打破工程設計與生產現場的資訊藩籬,將設備條件、運轉參數與營運目標完整結合,AI 模型才能給出兼具安全與效益的實用建議。這標誌著工業數位轉型已從「蒐集數據」演進至「精準上下文賦能」的新階段。
背景補充
AVEVA(劍維軟體)為全球知名工業軟體巨頭,旗下收購的 PI System(現為 PI Data Infrastructure)長期以來是全球石化、電力與製造業採用的即時資料庫標準系統。
隨著工業 4.0 的推進,製造場域普遍採用 SCADA(用於集中監控現場設備數據)與 MES(用於管理生產線計畫與執行)等系統,但這些系統往往彼此獨立。數位孿生(Digital Twin)技術則是透過在電腦世界中建構一座與實體工廠一模一樣的虛擬模型,結合即時感測器數據與歷史工程圖資,達到事前模擬、故障預測與運轉最佳化的目的。
常見問題
工業 AI 在導入時遇到的最大瓶頸是什麼?
主要挑戰在於企業內部的運運與工程資料分散於 HMI、SCADA、MES 等獨立系統中,欠缺統一的工業情境脈絡與治理架構,導致 AI 模型難以精準判讀與進行跨系統協作。
什麼是數位孿生(Digital Twin),對製造業有何幫助?
數位孿生是在數位環境中建立實體設備或製程的動態虛擬模型,透過結合即時營運數據與歷史工程資產資訊,協助企業進行運轉模擬、故障預測與營運最佳化。
企業若想推動 AI 應用規模化,首要步驟為何?
企業應優先建立連貫且可信賴的資料基礎架構,確保設備運轉與工程圖資具備完整的上下文情境,並建立回饋至實體工作流程的閉環機制,而非僅停留在單點試驗。