數位發展部、文化部與經濟部智慧財產局近日首度跨部會召開意見交流會議,邀集內容產業創作者與人工智慧(AI)應用業者,共同探討訓練資料授權與著作權權益。政府計畫推進民間優質資料數位化,並鼓勵 AI 開發者建立使用報酬給付機制,以期兼顧創新研發與創作者權益。
跨部會推動法制草案與授權機制
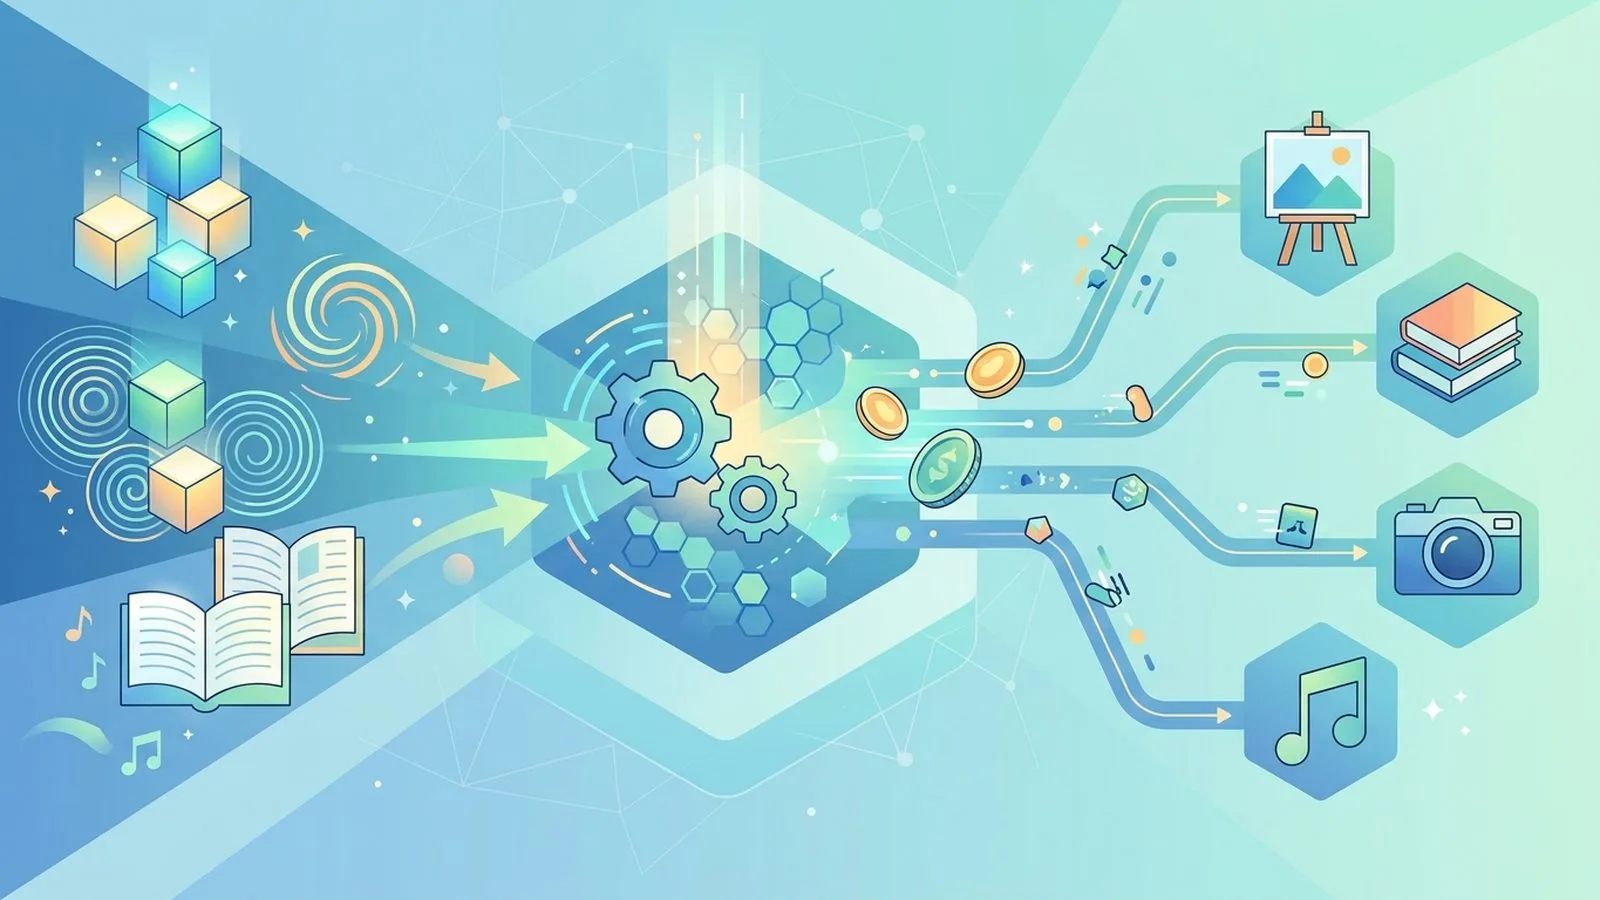
針對生成式人工智慧(Generative AI)快速發展所帶來的侵權疑慮,智慧局與數發部已著手研擬相關規範,分別提出《生成式人工智慧著作權指引》草案以及《促進資料創新利用發展條例》草案。官方指出,AI 模型的研發極度依賴高品質語料,而創作者則關切作品是否遭未授權利用及合理回饋。政府期望建立制度化的授權條款,引導業者透過給付使用報酬取得合法資料,形成產業與創作者雙贏的生態系。
主權 AI 語料庫建置與民間徵集
在推動在地技術發展方面,數發部提出「模型可換、資料可控」的核心策略,強調底層模型可隨技術演進彈性替換,但關鍵訓練資料必須由台灣自主掌控。政府建置的台灣主權 AI 訓練語料庫,先前以各級政府公部門資料為主,至今年十月中旬已累積達三十三億個權牌(Tokens)。未來將進一步擴大徵集民間自願授權語料,並明確承諾絕不強制要求民間無償提供,優先開放不涉及個人資料且授權齊備的公部門資訊供產業使用。
這代表什麼
這代表台灣在推進生成式 AI 應用時,開始著手建立一套可預測的合規路徑。對中小企業與 AI 技術開發商而言,過往使用網路公開資料訓練模型容易面臨潛在的法律訴訟風險,未來若有明確的授權指引與給付機制,將能大幅降低法令不確定性,讓業者在合法合規的前提下進行技術創新。
對在地內容創作者與數位出版業來說,這項政策宣示意味著原創作品不再只是被免費擷取的訓練素材。透過制度化的商業授權與分潤模式,創作者將有機會共享科技進步帶來的商業價值,不僅能保障創作經濟收益,也有助於確保台灣在地文化、語言與多元觀點能在 AI 時代持續留存與傳播。
背景補充
全球在發展大型語言模型(LLM)時,國際科技巨頭常因未經授權爬取網頁資料而面臨大量著作權訴訟。為了避免台灣的文化與語言習慣在國外大型模型中被邊緣化,政府積極推動「主權 AI」概念,意指擁有具備在地文化特徵、語言習慣且符合國內法規規範的 AI 體系。
在 AI 資料處理中,權牌(Token)是模型用來理解與處理文字的基本單位,可能代表一個字、詞彙或符號。建置在地語料庫並確立授權機制,正是為台灣本土 AI 產業提供穩定且具法律保障的「數位燃料」,確保技術發展不至於受到國際版權爭議阻礙。
常見問題
政府建置的主權 AI 語料庫會強制民間提供資料嗎?
不會。政府強調不會強制要求民間無償提供語料,民間資料募集以自願授權為原則,優先開放公部門無涉及個資且授權齊備的資訊。
這次會議主要推動了哪些相關法制草案?
主要包含智慧局研訂的《生成式人工智慧著作權指引》草案,以及數發部推動的《促進資料創新利用發展條例》草案。
使用報酬給付機制對 AI 開發業者有什麼好處?
建立明確的使用報酬給付機制,能協助業者取得合法合規的高品質訓練資料,降低未來面臨智慧財產權訴訟與侵權指控的法律風險。